2016년 06월 22일 트렌드디비
두 사람이 만났을 때 우리는 그 두 사람이 악수를 할지, 포옹을 할지 다음의 행동을 예상할 수 있다. 이러한 직관력은 삶에서 축적된 경험을 통해 자연스럽게 생겨난 것이다. 딥 러닝 방식으로 지식을 얻고 학습하는 인공지능은 관찰을 통해 사람이 있다, 어떤 사물이 있다와 같은 객관적인 상황은 인식할 수 있다. 그러나 사람들이 하고 있는 행동을 그들의 시선에서 이해하지 못하기 때문에 행동에 따른 반응도 정확히 예측하기 어렵다. MIT 컴퓨터공학 지능연구소가 개발한 컴퓨터 비전 알고리듬은 여기에 대한 해답을 제시한다. 액션-프리딕션 알고리듬이 작동하는 방식은 화가가 그림을 그려가는 과정과도 같다. 관찰한 장면을 이미지화해 개별 픽셀로 나눈뒤, 정보를 바탕으로 미래의 이미지를 재구성하는 것이다. 다중 신경망을 이루는 각각의 알고리듬이 다음으로 나타날 상황을 분석하면, 그것들을 종합하여 사람들이 다음으로 취할 행동을 최종으로 예측한다. 예를 들어, 두 명의 사람이 팔을 올리는 위치에 따라서 하이파이브를 할 것이라고 예상할 수 있다. 또한 지금은 없지만 다음의 장면에 사물이 나타날 것을 예측할 수도 있다. 예를 들어, 캐릭터가 전자레인지 앞으로 다가가면 머그잔이, 계단을 오르면 문이 나올 것이라 생각한다. 현재는 43%의 정확도를 보이지만 앞으로 개발을 거친다면 유용하게 활용될 것이다. 인공지능이 관찰한 대상의 직접적인 정보를 넘어서 내포된 의미와 암시도 더욱 섬세히 파악한다.
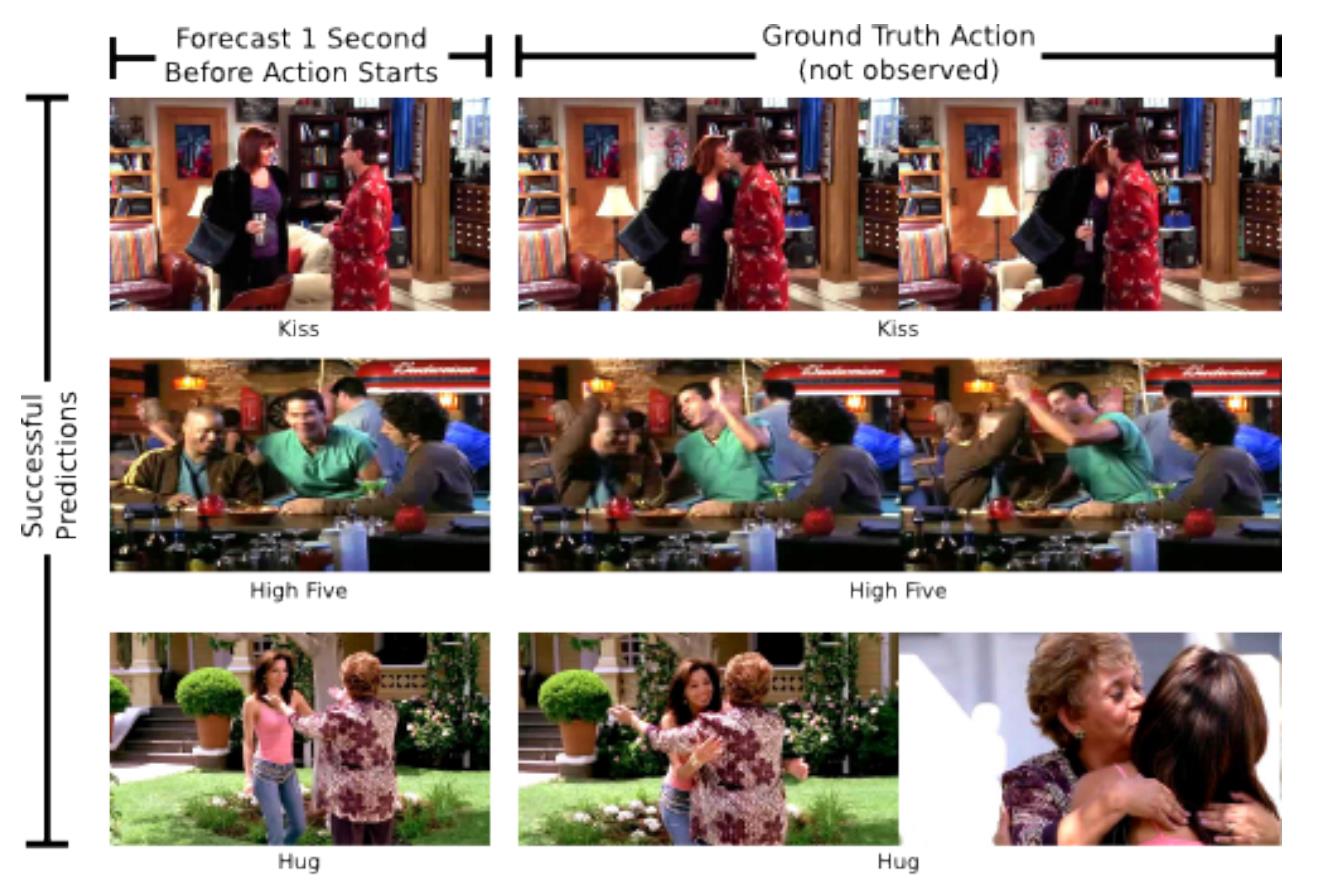
Action-Prediction Algorithms, MIT CSAIL(2016/06)
삭제하시겠습니까?
디지털 사이니지 기술이 발전하면서 실시간으로 주변 상황이나 사이니지 앞...
자전거를 타고 차량이 이동하는 도로를 달린다는 것은 늘 위험한 일이기에 ...
거울 위로 실생활에 필요한 정보를 띄워주거나, 장소와 날씨에 맞춰 조도를 ...
스냅챗은 지난해 1월에 사용자가 실제 사물을 사진으로 찍으면 그것을 기반...
두 사람이 만났을 때 우리는 그 두 사람이 악수를 할지, 포옹을 할지 다음의...